Changelog:
- Nueva creación — Septiembre 2026
Apuntes en creación
Esta sesión está en construcción. La versión final se publicará durante Octubre de 2026.
Transformación con dbt
En sesiones anteriores hemos hecho varias cosas por separado. En la sesión de ingesta de datos con dlt resolvimos la E y la L: extrajimos retail_db de MySQL y lo cargamos tal cual en DuckDB, dentro del esquema retail_db. Y en la sesión de modelado dimensional diseñamos y construimos a mano el esquema en estrella sobre esos datos: la tabla de hechos fact_ventas, las dimensiones dim_producto, dim_cliente y dim_fecha, con sus claves subrogadas y su miembro desconocido.
Aquella estrella la montamos con scripts sueltos de CREATE TABLE AS: funcionaban, pero eran un conjunto de sentencias que había que ejecutar en el orden correcto, a mano, sin versionar y sin forma de saber qué depende de qué.
En esta sesión damos el salto que anunciamos entonces: nos vamos a centrar en la T e industrializar esas mismas transformaciones con dbt. La lógica SQL es prácticamente la misma; lo que cambia es que pasa a ser un proyecto de ingeniería —versionado, con dependencias explícitas, materialización configurable y documentación— en lugar de un puñado de consultas.
Dónde encaja dbt
dbt no extrae ni carga datos: se apoya en el motor que ya los tiene (en nuestro caso DuckDB) y le manda SELECT. Es la pieza de transformación de un stack ELT moderno. La lógica sigue siendo SQL; lo que aporta dbt es ingeniería de software alrededor de ese SQL: dependencias, entornos, control de versiones, documentación y pruebas.
Analytics engineering
Durante años hubo dos perfiles muy separados. El ingeniero de datos (data engineer) montaba infaestructura y movía datos, pero no conocía el negocio. El analista de datos (data analyst) conocía el negocio y escribía SQL —justo lo que hicimos en la sesión de modelado— pero trabajaba con consultas sueltas, sin control de versiones, que nadie más podía reutilizar ni verificar.
El ingeniero analítico (analytics engineer) es el puente: aplica prácticas de desarrollo de software (control de versiones, modularidad, pruebas, revisión de código, integraciones continuas, documentación) al trabajo analítico en SQL. En lugar de los scripts de CREATE TABLE que ejecutábamos a mano, produce un repositorio de modelos versionado, documentado y reproducible.
Linaje de los datos
El linaje de los datos es la información de qué modelo depende de qué otro modelo o fuente. dbt lo construye automáticamente y lo dibuja en un grafo navegable.
De dicha necesidad surgió dbt, la herramienta que popularizó ese rol. Un modelo dbt es, simplemente, un SELECT guardado en un fichero .sql. dbt se encarga de convertir ese SELECT en una vista o una tabla dentro del almacén, de resolver en qué orden ejecutar los modelos y de mantener el linaje entre ellos. No hay que aprender un lenguaje nuevo: el 95 % es SQL, el mismo que ya hemos utilizado hasta ahora.
dbt Core y dbt Cloud
Existen dos formas de usar dbt:
- dbt Core es la herramienta de línea de comandos, de código abierto (licencia Apache 2.0). Es lo que usaremos: gratis, se ejecuta en local o en cualquier orquestador como Airflow o Prefect, y no depende de ningún servicio.
- dbt Cloud es el producto SaaS comercial de dbt Labs: añade IDE web, planificador, control de accesos y observabilidad sobre dbt Core.
Todo lo que veremos funciona con dbt Core. Para conectarnos con DuckDB usaremos el adaptador dbt-duckdb, que es un plugin instalable aparte.
¿Y dbt Fusion?
Desde 2025 dbt Labs desarrolla Fusion, un motor nuevo escrito en Rust que sustituye al motor histórico en Python. No es un dbt distinto: usa el mismo lenguaje de proyecto (modelos, ref(), YAML), pero al comprender el SQL de forma nativa aporta compilación local, detección de errores en el editor y linaje a nivel de columna, además de ser mucho más rápido en proyectos grandes.
Instalación
Si quieres instalar dbt Core y el adaptador dbt-duckdb en tu máquina, la forma más sencilla es con pip:
pip install dbt-duckdb
dbt --version
Al instalar dbt-duckdb se arrastran como dependencias tanto dbt-core como duckdb, así que no hay que instalarlos por separado.
En nuestro caso, como ya está instalado en el contenedor iabd-lab (recuerda que te puedes conectar mediante docker exec -it iabd-lab bash), podemos comprobar directamente la instalación mediante:
dbt --version
# Core:
#   - installed: 1.12.3
#   - latest:    1.12.3 - Up to date!

# Plugins:
#   - duckdb: 1.11.0 - Up to date!
Un comando, muchos subcomandos
dbt funciona con subcomandos, al estilo de git: dbt run, dbt debug, dbt docs, dbt ls... Los iremos viendo a lo largo de la sesión.
Estructura de un proyecto
El primer paso es crear un proyecto dbt, que es un repositorio de modelos versionado y documentado. Para ello, ejecutaremos el comando dbt init:
dbt init iabd_retail
El comando pregunta el adaptador y genera un esqueleto de carpetas:
iabd/
├── profiles.yml             # cómo conectar con el almacén
iabd_retail/
├── dbt_project.yml          # configuración del proyecto
Como puedes observar, tenemos dos carpetas por separado, una para el proyecto dbt (iabd_retail) y otra para el fichero profiles.yml que contiene la conexión con DuckDB, y que dbt mantiene a propósito fuera del proyecto, porque ahí van las credenciales y no deben acabar versionadas en git.
Así pues, la carpeta iabd almacena la conexión. En una instalación por defecto, normalmente, la ruta sería ~/.dbt/profiles.yml, pero en nuestro caso la hemos configurado previamente mediante la variable de entorno DBT_PROFILES_DIR del docker-compose.yml.
Las tres zonas, ahora como código
La estructura recomendada de un proyecto dbt no es una convención arbitraria: es la misma división en zonas que ya conocemos, expresada en carpetas.
models/
├── staging/        ← una vista por cada tabla del origen, sin lógica de negocio
├── intermediate/   ← limpieza, combinaciones y cálculos reutilizables
└── marts/          ← hechos, dimensiones y tablas de negocio
La correspondencia entre los tres vocabularios que hemos ido usando:
| Zona | Bucket en MinIO | Carpeta en dbt | Qué contiene | Materialización habitual |
|---|---|---|---|---|
| Aterrizaje | raw-data |
staging |
los datos del origen, renombrados y tipados, sin más | vista |
| Procesado | processed |
intermediate |
lógica intermedia reutilizable entre varios marts | vista o tabla |
| Presentación | warehouse |
marts |
fact_ventas, dim_producto, dim_cliente, dim_fecha y los marts de negocio |
tabla |
La razón de que staging se materialice como vista y los marts como tabla encaja con el propósito de cada zona. Una vista de staging no ocupa espacio y siempre refleja el estado actual del origen; un mart se consulta muchas veces al día y compensa pagar el coste de materializarlo una vez.
Una regla de oro del staging
En staging no se hace lógica de negocio: solo renombrar columnas, ajustar tipos y poco más. Un modelo de staging debe poder leerse al lado de la tabla de origen y reconocerse sin esfuerzo. Toda decisión de negocio vive aguas abajo, en intermediate o en marts, donde se puede documentar y probar.
Dos salas o tres zonas
La división original de Kimball es de dos: la trastienda, donde ocurre todo el proceso de ETL, y la sala, el área de presentación que consume el negocio. Partir la trastienda en aterrizaje y procesado es la lectura moderna de esa misma propuesta, nacida de que el almacenamiento barato permite conservar indefinidamente una copia intacta del origen, algo impensable cuando Kimball escribió su libro.
Conviene además no tomarse la frontera de forma dogmática. Kimball insistía en que el comensal no entra en la cocina, y con razón para los informes corporativos; pero en la práctica actual es normal que un analista consulte directamente una tabla de staging para investigar una anomalía. La regla sigue viva para lo que se publica; para explorar, la puerta está más abierta de lo que estaba en los noventa.
Configuración: dbt_project.yml
El fichero dbt_project.yml es el corazón del proyecto. Ahí se declara el nombre del proyecto, qué profile utiliza y la configuración por defecto de cada carpeta de modelos. En nuestro caso, queremos que todo lo que yazca bajo staging/ se materialice como vista y lo que esté bajo marts/ como tabla:
name: 'iabd_retail'
version: '1.0.0'
profile: 'iabd_retail'

model-paths: ["models"]

# analysis-paths: ["analyses"] test-paths: ["tests"] ... rutas para otros tipos de artefactos que no usaremos en esta sesión

models:
  iabd_retail:
    staging:
      +materialized: view      # todo lo de staging/ será una vista
    marts:
      +materialized: table     # todo lo de marts/ será una tabla
Así pues, el resultado al que llegaremos una vez hayamos creado el modelo dimensional en estrella será similar al siguiente:
---
config:
    treeView-beta:
        showIcons: false
---
treeView-beta
    iabd_retail/
        dbt_project.yml          :::highlight   ## configuración del proyecto
        models/
            staging/             :::highlight   ## capa de limpieza (1 modelo por tabla origen)
                _retail_sources.yml
                stg_customers.sql
                stg_orders.sql
                stg_order_items.sql
                stg_products.sql
                stg_categories.sql
                stg_departments.sql
            marts/               :::highlight   ## la estrella (tablas de negocio)
                dim_producto.sql
                dim_cliente.sql
                dim_fecha.sql
                fact_ventas.sql
                ingresos_por_departamento.sql
Conexión: profiles.yml
dbt separa qué transformar (los modelos, versionados en el repo) de dónde hacerlo (la conexión, que cambia entre tu portátil y producción). Esa conexión vive en profiles.yml.
En un entorno real este fichero va en ~/.dbt/profiles.yml para no meter las credenciales en el repositorio; en clase lo dejamos junto al proyecto para tenerlo todo a la vista.
iabd_retail:              # debe coincidir con 'profile:' de dbt_project.yml
  target: dev
  outputs:
    dev:
      type: duckdb
      path: /workspace/dbt/iabd/retail_el.duckdb
      schema: main
      threads: 4
Para que nos funcione con duckdb, vamos a copiar el fichero retail.duckdb que generó dlt en la sesión de ingesta a la carpeta del proyecto dbt:
cp /workspace/retail_el.duckdb /workspace/dbt/iabd/retail_el.duckdb
Antes de ejecutar nada, conviene comprobar que la conexión funciona mediante dbt debug:
16:45:59  Running with dbt=1.12.3
16:45:59  dbt version: 1.12.3
16:45:59  python version: 3.12.14
16:45:59  python path: /usr/local/bin/python3.12
16:45:59  os info: Linux-5.15.153.1-microsoft-standard-WSL2-x86_64-with-glibc2.41
16:45:59  Using profiles dir at /workspace/dbt/iabd
16:45:59  Using profiles.yml file at /workspace/dbt/iabd/profiles.yml
16:45:59  Using dbt_project.yml file at /workspace/dbt/iabd_retail/dbt_project.yml
16:45:59  adapter type: duckdb
16:45:59  adapter version: 1.11.0
16:45:59  Configuration:
16:45:59    profiles.yml file [OK found and valid]
16:45:59    dbt_project.yml file [OK found and valid]
16:45:59  Required dependencies:
16:45:59   - git [OK found]

16:45:59  Connection:
16:45:59    database: retail_el
16:45:59    schema: main
16:45:59    path: retail_el.duckdb
...
16:45:59    Connection test: [OK connection ok]
Bloqueo de escritura en DuckDB
Recuerda que DuckDB admite un único proceso escritor sobre el mismo fichero. Si tienes abierta una consola de DuckDB apuntando a retail_el.duckdb, dbt run fallará con un error de bloqueo. Cierra cualquier otra conexión antes de ejecutar dbt.
Caso 1. Cargando un modelo
Una vez tenemos la configuración inicial, vamos a configurar los elementos del proyecto.
Fuentes de datos
Los datos crudos que cargó dlt viven en el esquema retail_db que reside en el fichero retail_el.duckdb. Antes de transformarlos, debemos informarlos a dbt declarándolos como sources en un fichero YAML, el cual colocaremos en la carpeta models/staging/ y lo llamaremos _retail_sources.yml.
Esto no crea nada, solo le dice a dbt que dichas tablas ya existen y que serán la fuente de nuestros modelos:
version: 2

sources:
  - name: retail_db
    description: "Tablas crudas cargadas por dlt desde MySQL en la sesión de ingesta."
    database: retail_el
    schema: raw
    tables:
      - name: customers
      - name: orders
      - name: order_items
      - name: products
      - name: categories
      - name: departments
Al configurar aquí la fuente, dbt puede generar documentación y pruebas de integridad sobre ella, y además nos permite referenciarla en los modelos sin escribir el nombre real de la tabla origen. De esta manera, en el SQL de los modelos nunca escribimos el nombre real de la tabla origen, sino que en su lugar usamos la función source():
select * from {{ source('retail_db', 'customers') }}
¿Te suena la sintaxis {{ ... }}? Sí, es Jinja, un motor de plantillas que dbt intercala en el SQL.
En tiempo de compilación, dbt sustituye source('retail_db', 'customers') por "retail"."retail_db"."customers". Esto nos ofrece una mayor flexibilidad y mantenimiento, ya que si mañana el origen cambia de esquema, sólo debemos modificar una línea en el YAML y no cada consulta.
a, se toca una línea en el YAML y no cada consulta.
El primer modelo
Un modelo de staging hace un trabajo modesto pero imprescindible: leer una tabla cruda, seleccionar las columnas útiles, renombrarlas a un vocabulario consistente y poco más. El resultado es una tabla con un formato y nombres de columnas consistentes, listos para ser utilizados en los modelos de análisis.
Para cada una de las tablas, definiremos una consulta SQL en un fichero .sql dentro de models/staging/. Por ejemplo, el modelo stg_orders.sql lee la tabla orders y renombra las columnas a un vocabulario consistente:
with fuente as (
    select * from {{ source('retail_db', 'orders') }}
)
select
    order_id as pedido_id,
    cast(order_date as date) as fecha,      -- dlt cargó la fecha como timestamp, aquí la convertimos a DATE
    order_customer_id as cliente_id,
    order_status as estado
from fuente
Aquí ya podemos ver el valor de la capa de staging, donde la columna order_date llegó como timestamp desde la ingesta, y la convertimos a DATE de una vez para todo el proyecto. En la sesión de modelado ese CAST lo repetíamos en cada consulta; ahora se hace una sola vez y todo lo que consuma stg_orders ya recibe la fecha con su tipo.
Para poder probar el modelo, podemos ejecutar:
dbt run --select stg_orders
# 17:48:51  Running with dbt=1.12.3
# 17:48:51  Registered adapter: duckdb=1.11.0
# 17:48:52  [WARNING]: Configuration paths exist in your dbt_project.yml file which do not apply to any resources.
# There are 1 unused configuration paths:
# - models.iabd_retail.marts
# 17:48:52  Found 1 model, 6 sources, 500 macros
# 17:48:52
# 17:48:52  Concurrency: 4 threads (target='dev')
# 17:48:52
# 17:48:52  1 of 1 START sql view model main.stg_orders ..................................... [RUN]
# 17:48:52  1 of 1 OK created sql view model main.stg_orders ................................ [OK in 0.09s]
# 17:48:52
# 17:48:52  Finished running 1 view model in 0 hours 0 minutes and 0.18 seconds (0.18s).
# 17:48:52
# 17:48:52  Completed successfully
# 17:48:52
# 17:48:52  Done. PASS=1 WARN=0 ERROR=0 SKIP=0 NO-OP=0 REUSED=0 TOTAL=1
Y si queremos comprobar que el modelo se ha creado correctamente, podemos abrir una consola de DuckDB y ejecutar un SELECT sobre la vista stg_orders:
duckdb /workspace/dbt/iabd/retail_el.duckdb
y comprobar que se ha creado la vista stg_orders en el esquema main de DuckDB, con los nombres de las columnas y tipos de datos que hemos definido en el modelo:
select * from main.stg_orders limit 5;
-- ┌───────────┬────────────┬────────────┬────────────┐
-- │ pedido_id │   fecha    │ cliente_id │   estado   │
-- │   int64   │    date    │   int64    │  varchar   │
-- ├───────────┼────────────┼────────────┼────────────┤
-- │     25885 │ 2014-01-01 │       7253 │ PENDING    │
-- │     25894 │ 2014-01-01 │       7839 │ PROCESSING │
-- │     25915 │ 2014-01-01 │       2963 │ COMPLETE   │
-- │     25942 │ 2014-01-01 │       1117 │ PROCESSING │
-- │     25954 │ 2014-01-01 │       2582 │ PROCESSING │
-- └───────────┴────────────┴────────────┴────────────┘
El resto de los modelos de staging
Los cinco siguen el mismo patrón que stg_orders: leen una fuente con source(), seleccionan las columnas útiles y las renombran al vocabulario del proyecto. Ni joins ni agregaciones: una tabla origen por modelo.
with fuente as (
    select * from {{ source('retail_db', 'customers') }}
)
select
    customer_id as cliente_id,
    customer_fname as nombre,
    customer_lname as apellido,
    customer_email as email,
    customer_city as ciudad,
    customer_state as provincia
from fuente
with fuente as (
    select * from {{ source('retail_db', 'order_items') }}
)
select
    order_item_id as linea_id,
    order_item_order_id as pedido_id,
    order_item_product_id as producto_id,
    order_item_quantity as cantidad,
    order_item_subtotal as subtotal,
    order_item_product_price as precio_unitario
from fuente
with fuente as (
    select * from {{ source('retail_db', 'products') }}
)
select
    product_id as producto_id,
    product_category_id as categoria_id,
    product_name as nombre,
    product_price as precio
from fuente
with fuente as (
    select * from {{ source('retail_db', 'categories') }}
)
select
    category_id as categoria_id,
    category_department_id as departamento_id,
    category_name as nombre
from fuente
with fuente as (
    select * from {{ source('retail_db', 'departments') }}
)
select
    department_id as departamento_id,
    department_name  as nombre
from fuente
Creando una dimensión con ref()
Cuando un modelo depende de otro modelo (y no de una fuente), debemos emplear ref() en lugar de source(). Este es el mecanismo más importante de dbt. Fíjate en dim_producto, la misma dimensión de la sesión de modelado —clave subrogada con row_number(), LEFT JOIN hacia categoría y departamento, y la fila del miembro desconocido— pero ahora leyendo de modelos de staging con ref():
with productos as (
    select * from {{ ref('stg_products') }}
),
categorias as (
    select * from {{ ref('stg_categories') }}
),
departamentos as (
    select * from {{ ref('stg_departments') }}
),
base as (
    select
        row_number() over (order by p.producto_id) as producto_sk,
        p.producto_id,
        p.nombre as nombre,
        coalesce(c.nombre, '(sin asignar)') as categoria,
        coalesce(d.nombre, '(sin asignar)') as departamento,
        p.precio as precio_catalogo
    from productos p
    left join categorias c on p.categoria_id = c.categoria_id
    left join departamentos d on c.departamento_id = d.departamento_id
)
select * from base
union all
select -1, -1, '(desconocido)', '(desconocido)', '(desconocido)', 0   -- miembro desconocido
ref() construye el grafo por ti
Cada vez que un modelo referencia a otro con ref(), dbt anota esa dependencia. Con el conjunto de todas las dependencias construye un DAG (grafo dirigido acíclico) y deduce el orden de ejecución: primero staging, después las dimensiones, después el hecho que las referencia, y por último el informe. Nunca ordenamos nosotros las ejecuciones a mano; ese trabajo —el que en la sesión de modelado hacíamos vigilando el orden de los CREATE TABLE— es justo el que dbt nos quita.
Capas: staging y marts
No metemos todos los modelos en un saco. Un proyecto dbt se organiza en capas, y la convención más extendida distingue al menos dos:
- staging — una vista por cada tabla origen. Limpieza ligera: renombrar columnas, castear tipos, estandarizar. No se hacen joins ni agregaciones. Es la "aduana" por donde entra todo dato crudo. Prefijo
stg_. - marts — las tablas de negocio ya listas para consumo. Aquí vive nuestra estrella: las dimensiones (
dim_), el hecho (fact_ventas) y los informes que se apoyan en ellos.
Nombres consistentes con la sesión de modelado
Mantenemos los nombres que ya fijamos a mano: fact_ventas, dim_producto, dim_cliente, dim_fecha. Parte de la documentación de dbt usa el prefijo fct_ para los hechos; aquí priorizamos la coherencia con lo que el alumnado ya construyó frente a la convención externa.
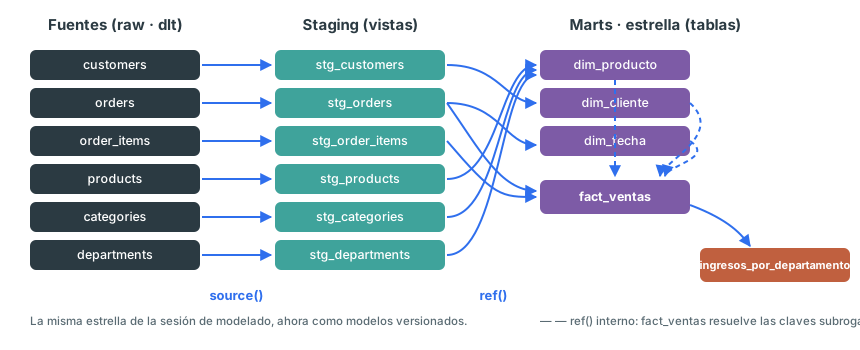
La tabla de hechos conserva el grano de línea de pedido que decidimos en modelado (una fila por producto dentro de un pedido) y resuelve las claves subrogadas contra las dimensiones con ref(), redirigiendo al miembro desconocido con coalesce(..., -1):
with lineas as (
    select * from {{ ref('stg_order_items') }}
),
pedidos as (
    select * from {{ ref('stg_orders') }}
),
producto as (
    select * from {{ ref('dim_producto') }}
),
cliente as (
    select * from {{ ref('dim_cliente') }}
)
select
    l.linea_id,
    p.pedido_id                      as pedido_id,       -- dimensión degenerada
    coalesce(dc.cliente_sk,  -1)     as cliente_sk,
    coalesce(dp.producto_sk, -1)     as producto_sk,
    p.fecha                          as fecha_id,
    p.estado,
    l.cantidad,                                          -- aditiva
    l.subtotal                       as importe,         -- aditiva
    l.precio_unitario                                    -- NO aditiva
from lineas l
join pedidos p on l.pedido_id = p.pedido_id
left join producto dp on dp.producto_id = l.producto_id
left join cliente  dc on dc.cliente_id  = p.cliente_id
Para ver qué genera realmente ref(), podemos mirar el SQL compilado (dbt lo deja en target/compiled/). Las llamadas Jinja han desaparecido y en su lugar hay nombres de tabla reales; observa cómo las dimensiones se resuelven a tablas del esquema main:
with lineas as (
    select * from "retail"."main"."stg_order_items"
),
pedidos as (
    select * from "retail"."main"."stg_orders"
),
producto as (
    select * from "retail"."main"."dim_producto"
),
cliente as (
    select * from "retail"."main"."dim_cliente"
)
...
Y el último mart, ingresos_por_departamento, cierra el bucle con la pregunta que abría la sesión de modelado. Allí, responder ¿cuánto ingresamos por departamento? costaba cuatro tablas y tres combinaciones; sobre la estrella es un SELECT con un solo join:
with ventas as (
    select * from {{ ref('fact_ventas') }}
),
producto as (
    select * from {{ ref('dim_producto') }}
)
select
    dp.departamento,
    count(distinct v.pedido_id)   as pedidos,
    sum(v.cantidad)               as unidades,
    round(sum(v.importe), 2)      as ingresos
from ventas v
join producto dp on dp.producto_sk = v.producto_sk
where v.estado in ('COMPLETE', 'CLOSED')
group by dp.departamento
order by ingresos desc
Las otras dos dimensiones: dim_cliente y dim_fecha
dim_cliente es idéntica en estructura a dim_producto: clave subrogada con
row_number() y su fila para el miembro desconocido.
with clientes as (
    select * from {{ ref('stg_customers') }}
),
base as (
    select
        row_number() over (order by cliente_id)   as cliente_sk,
        cliente_id,
        nombre || ' ' || apellido                 as nombre,
        ciudad,
        provincia
    from clientes
)
select * from base
union all
select -1, -1, '(desconocido)', '(desconocido)', '(desconocido)'   -- miembro desconocido
dim_fecha no sale de ninguna tabla origen: se genera a partir del rango
de fechas de los pedidos (con range() de DuckDB) y deriva los atributos de
calendario que luego facilitan agrupar por mes, trimestre o día de la semana.
with limites as (
    select min(fecha) as desde, max(fecha) as hasta
    from {{ ref('stg_orders') }}
),
dias as (
    select unnest(range(
        (select desde from limites),
        (select hasta from limites) + interval 1 day,
        interval 1 day
    ))::date as fecha_id
)
select
    fecha_id,
    year(fecha_id)     as anio,
    quarter(fecha_id)  as trimestre,
    month(fecha_id)    as mes,
    ['enero','febrero','marzo','abril','mayo','junio','julio',
        'agosto','septiembre','octubre','noviembre','diciembre'][month(fecha_id)] as mes_nombre,
    isodow(fecha_id)   as dia_semana,
    ['lunes','martes','miércoles','jueves','viernes','sábado',
        'domingo'][isodow(fecha_id)] as dia_nombre,
    isodow(fecha_id) >= 6 as es_finde
from dias
Materializaciones: view y table
La materialización decide cómo persiste dbt el resultado de un modelo en el almacén. En esta sesión usamos las dos básicas:
- view — dbt crea una vista (
CREATE VIEW). No ocupa espacio y siempre refleja los datos más recientes, pero se recalcula en cada consulta. Ideal para staging, donde la lógica es ligera. - table — dbt crea una tabla física (
CREATE TABLE AS SELECT). Ocupa espacio y hay que reconstruirla para actualizarla, pero se consulta rápido porque el cálculo ya está hecho. Es exactamente lo que hacíamos a mano con losCREATE TABLE ASde la estrella; ahora lo declara la carpeta.
La materialización se puede fijar por carpeta en dbt_project.yml (como hicimos) o modelo a modelo con un bloque config() al principio del .sql:
{{ config(materialized='table') }}

select ...
Lo que aún hacemos a mano y dbt hará por nosotros
En la sesión de modelado generamos las claves subrogadas con row_number() y versionamos la dimensión de cliente como SCD tipo 2 escribiendo el histórico paso a paso. Esas dos piezas —claves subrogadas estables y versionado SCD— son precisamente las que dbt industrializa con sus snapshots y con macros como generate_surrogate_key. Junto con las materializaciones incrementales para cargar el hecho sin reconstruirlo entero, las veremos en la sesión de cierre del bloque, ya sobre el pipeline completo dlt → DuckDB → dbt.
Ejecutar el proyecto
El comando estrella es dbt run. Compila todos los modelos, resuelve el orden a partir del DAG y los ejecuta contra DuckDB:
Concurrency: 4 threads (target='dev')

1 of 11 OK created sql view model main.stg_categories .............. [OK in 0.21s]
...
6 of 11 OK created sql view model main.stg_products ................ [OK in 0.08s]
7 of 11 OK created sql table model main.dim_cliente ............... [OK in 0.13s]
8 of 11 OK created sql table model main.dim_producto ............. [OK in 0.10s]
9 of 11 OK created sql table model main.dim_fecha ................ [OK in 0.07s]
10 of 11 OK created sql table model main.fact_ventas ............. [OK in 0.04s]
11 of 11 OK created sql table model main.ingresos_por_departamento [OK in 0.07s]

Finished running 5 table models, 6 view models in 0.79 seconds.
Done. PASS=11 WARN=0 ERROR=0 SKIP=0 TOTAL=11
Observa el orden que eligió dbt: primero las 6 vistas de staging, después las 3 dimensiones, luego fact_ventas (que depende de ellas) y por último el informe. Nadie se lo dijo; lo dedujo del grafo de ref(). Y ejecuta en paralelo lo que puede (4 hilos), respetando siempre las dependencias.
No siempre queremos reconstruir todo. Con --select se ejecuta un subconjunto. El operador + a la derecha del nombre incluye el modelo y todo lo que depende de él (aguas abajo):
dbt run --select stg_products+
1 of 4 OK created sql view model main.stg_products ................ [OK in 0.10s]
2 of 4 OK created sql table model main.dim_producto ............. [OK in 0.10s]
3 of 4 OK created sql table model main.fact_ventas ............. [OK in 0.06s]
4 of 4 OK created sql table model main.ingresos_por_departamento [OK in 0.09s]
Done. PASS=4 ... TOTAL=4
Cambiar stg_products disparó la reconstrucción de dim_producto, del hecho y del informe, que dependen de él en cadena, y solo de esos. Para listar los modelos sin ejecutarlos está dbt ls:
iabd_retail.marts.dim_cliente
iabd_retail.marts.dim_fecha
iabd_retail.marts.dim_producto
iabd_retail.marts.fact_ventas
iabd_retail.marts.ingresos_por_departamento
iabd_retail.staging.stg_customers
...
Comprobar el resultado
Igual que en la sesión de modelado, toda carga de un hecho termina con un control de calidad. La misma consulta de entonces, ahora sobre el fact_ventas que ha construido dbt:
┌───────┬──────────────┬─────────────┬─────────┬───────────────┐
│ filas │ sin_producto │ sin_cliente │ pedidos │ importe_total │
├───────┼──────────────┼─────────────┼─────────┼───────────────┤
│   508 │            0 │           0 │     200 │      169034.4 │
└───────┴──────────────┴─────────────┴─────────┴───────────────┘
508 filas (el grano de línea coincide con order_items), ninguna redirigida al miembro desconocido y 200 pedidos distintos. La dimensión de producto conserva su miembro desconocido:
┌───────┬─────────────────────┐
│ filas │ miembro_desconocido │
├───────┼─────────────────────┤
│    55 │                   1 │
└───────┴─────────────────────┘
Y el informe final, ya consultable por cualquier herramienta de BI, responde a la pregunta con la que empezó todo:
┌──────────────┬─────────┬──────────┬──────────┐
│ departamento │ pedidos │ unidades │ ingresos │
├──────────────┼─────────┼──────────┼──────────┤
│ Apparel      │      47 │      172 │ 25618.28 │
│ Outdoors     │      38 │      148 │ 20268.52 │
│ Fan Shop     │      51 │      171 │ 19278.29 │
│ Golf         │      36 │      146 │ 12578.54 │
│ Fitness      │      44 │      178 │ 10828.22 │
│ Footwear     │      37 │      114 │  6348.86 │
└──────────────┴─────────┴──────────┴──────────┘
Documentación y linaje
dbt genera documentación del proyecto a partir del propio código y los ficheros YAML. Con dos comandos se construye y se sirve un sitio web navegable:
dbt docs generate
dbt docs serve
Building catalog
Catalog written to target/catalog.json
Ese sitio incluye el catálogo de modelos, sus columnas y descripciones, y —lo más útil— el grafo de linaje interactivo: de un vistazo se ve qué source alimenta a qué modelo y qué depende de cuál, incluida la resolución de fact_ventas contra sus dimensiones. Es la misma información que usa dbt para ordenar dbt run, pero dibujada.
Puesta en práctica de extremo a extremo
Recapitulando el hilo completo de las tres sesiones:
- dlt cargó
retail_dbdesde MySQL a DuckDB (esquemaretail_db) — la E y la L. - En modelado dimensional diseñamos la estrella y la construimos a mano con
CREATE TABLE AS. - Ahora dbt industrializa esa misma estrella: sources para el raw, staging para la limpieza, y marts para dimensiones, hecho e informe, todo enlazado con
ref(). dbt runresolvió el orden por el grafo y lo ejecutó;dbt docsdocumentó el resultado.
Todo el "movimiento" de datos lo hizo el motor (DuckDB). dbt solo orquestó SELECT. Esa es la esencia del ELT moderno: cargar primero, transformar dentro del almacén con SQL versionado.
FAQ
¿dbt mueve o copia los datos entre sistemas?
No. dbt no tiene motor de datos propio: envía sentencias SQL al almacén (DuckDB, en nuestro caso) y es ese motor el que hace el trabajo. Por eso dbt cubre solo la T del ELT; la extracción y la carga las hizo dlt.
¿Cuándo uso source() y cuándo ref()?
source() para las tablas crudas que entraron desde fuera (las que declaraste en el YAML de sources). ref() para referirte a otro modelo de tu propio proyecto. Regla práctica: si el nombre lleva prefijo stg_, dim_ o fact_, es un modelo tuyo y va con ref().
¿Por qué staging como vista y marts como tabla?
Staging hace poco trabajo y conviene que siempre refleje el dato más reciente sin ocupar espacio: encaja con view. Los marts se consultan mucho y su cálculo es más costoso, así que interesa dejarlos persistidos y rápidos de leer: encaja con table, igual que los CREATE TABLE de la estrella. No es una regla rígida, es el punto de partida razonable.
¿Qué pasa si escribo mal el nombre dentro de un ref()?
dbt falla en la fase de compilación, antes de tocar la base de datos, con un error de tipo depends on a node named ... which was not found. Es una de las ventajas frente al SQL suelto: los errores de dependencia se detectan al compilar, no en producción.
¿Tengo que decirle a dbt en qué orden ejecutar los modelos?
No, y de hecho no se puede definir el orden a mano. dbt lo deriva del grafo de dependencias que construye con las llamadas a ref(). Por eso fact_ventas, que referencia a las dimensiones, siempre se ejecuta después de ellas sin que lo indiquemos.
Referencias
Actividades
Para las actividades reutilizamos el proyecto iabd_retail y la estrella que estamos industrializando. Cada modelo nuevo se materializa según su carpeta y se comprueba con dbt run.
-
(RABDA.1 / CEBDA.1b / 1p) Sources y staging. Comprueba que las seis tablas de
retail_dbestán declaradas como sources en_retail__sources.ymly que existe un modelo de staging por cada una. Añade astg_order_itemsla columnaprecio_unitario(a partir deorder_item_product_price) y ejecutadbt run --select stg_order_itemsconfirmando que se materializa como vista.Tip
Recuerda que un modelo de staging no hace joins: una source por modelo.
-
(RABDA.5 / CEBDA.5b / 2p) Limpieza en staging. En
stg_customers, además de renombrar, normaliza el email a minúsculas y crea una columnanombre_completo. Justifica en un comentario por qué esta limpieza va en staging y no en la dimensión, y comprueba quedim_clientesigue construyéndose sin tocar su SQL. -
(RASBD.1 / CESBD.1c CESBD.1d / 2p) La dimensión de cliente. Revisa
dim_clientey comprueba que reproduce la de la sesión de modelado: clave subrogada conrow_number()y miembro desconocido. Ejecutadbt run --select dim_clientey valida con una consulta que hay exactamente una fila concliente_sk = -1y que el resto de claves subrogadas son únicas. -
(RABDA.1 / CEBDA.1d / 2p) Materializaciones. Cambia la materialización de
ingresos_por_departamentodetableaviewmediante un bloqueconfig()en el propio modelo (sobrescribiendo la herencia de la carpeta). Ejecutadbt run --select ingresos_por_departamento, consulta elinformation_schemay verifica que el objeto pasó deBASE TABLEaVIEW. Vuelve a dejarlo comotabley razona en qué caso preferirías cada opción para un mart de informe. -
(RABDA.1 / CEBDA.1e / 1p) Documentación y linaje. Genera la documentación con
dbt docs generatey sírvela condbt docs serve. Localizafact_ventasen el grafo de linaje y anota, aguas arriba, todos los modelos y sources de los que depende hasta llegar aretail_db. Comprueba que aparecen las dependencias haciadim_productoydim_cliente. -
(RASBD.3 / CESBD.3a / 3p) Un nuevo informe sobre la estrella. Aprovechando
dim_fecha, crea el martventas_mensualesque devuelva, por año y mes, el número de pedidos completados y los ingresos totales, uniendofact_ventascondim_fechaporfecha_id. Decide y justifica su materialización, y captura la salida real dedbt runy de una consulta al modelo.Tip
Solo se cuentan pedidos en estado
COMPLETEoCLOSED, igual que eningresos_por_departamento. La ventaja de unir condim_fechaes que el nombre del mes y el trimestre ya vienen calculados.