Changelog:
- Nueva creación — Agosto 2026
Extracción y carga con dlt
En las sesiones anteriores hemos aprendido dónde dejar los datos (object storage sobre MinIO/S3) y en qué formato hacerlo (Parquet, particionado, compresión), y los hemos consultado con DuckDB y Trino.
Ahora nos vamos a centrar en la ingesta: cómo llegan los datos al lago. Esta sesión trata la ingesta como una etapa de primera clase y presenta dlt (data load tool), una librería de Python que se ha convertido en la forma idiomática de cargar datos crudos sin montar infraestructura.
EL antes que T
Durante años el patrón por defecto fue ETL: extraer de la fuente, transformar en un motor intermedio y cargar (load) ya limpio en el destino. La nube y el almacenamiento barato han invertido el orden hacia ELT (o, cuando la transformación se delega a otra herramienta como veremos con dbt, simplemente EL): primero se carga el dato crudo en el lago o el almacén, y la transformación se hace después, ya dentro del sistema analítico.
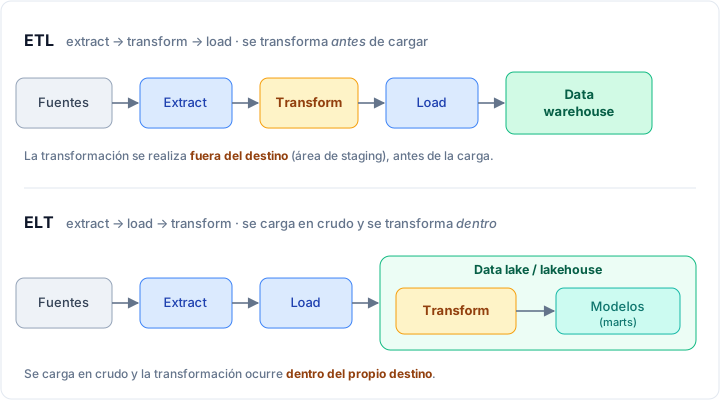
La idea de fondo es sencilla: no transformes lo que todavía no entiendes. La transformación es un proceso complejo y costoso, y necesita de un analísis previo de los datos.
Además, cargar en crudo primero tiene tres ventajas concretas:
- Reproducibilidad. Si guardamos la respuesta tal cual llegó de la fuente, siempre podemos reprocesarla con una lógica distinta. Si transformamos antes de guardar, hemos perdido para siempre aqullo que hayamos descartado.
- DesacoplamientO. La ingesta y la transformación pasan a ser dos trabajos independientes, con cadencias y responsabilidades distintas. Un fallo en la lógica de negocio no obliga a volver a invocar a la API.
- Coste. Recalcular sobre datos ya almacenados en Parquet es órdenes de magnitud más barato que volver a extraer de una API con límites de peticiones.
El lago como zona de aterrizaje
En nuestro montaje, la carga cruda va al bucket raw-data de MinIO en Parquet. La capa processed y el modelado quedan para la sesión de dbt. La ingesta se limita a mover el dato a casa con la mínima transformación imprescindible (tipado y normalización de estructura).
Patrones de ingesta
La ingesta de datos es un proceso complejo y propenso a errores. Por eso conviene reconocer los patrones habituales y las dificultades que se presentan.
Full load vs carga incremental
Una carga completa (full load) trae todo el origen en cada ejecución. Es simple y robusta, pero se vuelve inviable cuando la fuente crece: mueve datos que ya tenías.
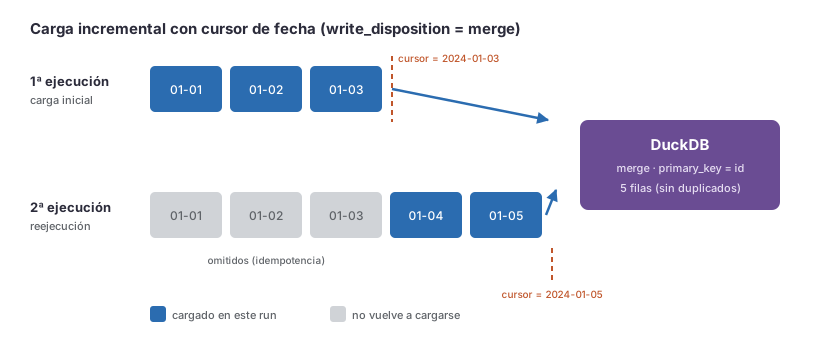
Una carga incremental trae solo lo nuevo o lo modificado desde la última ejecución. Para saber qué es nuevo se usa un cursor (también llamado watermark): un campo del recurso de origen que crece de forma monótona —típicamente una fecha de creación/modificación o un identificador autoincremental—. Guardaremos el último valor visto y en la siguiente ejecución pediremos solo lo que lo supera.
Idempotencia
Un pipeline es idempotente si ejecutarlo dos veces con la misma entrada deja el destino en el mismo estado que ejecutarlo una vez. Es la propiedad que permite reintentar sin miedo tras un fallo, o dejar el pipeline en un cron sin que duplique filas.
La idempotencia se consigue combinando dos cosas:
- un cursor que evita volver a traer lo ya cargado,
- y una clave primaria con estrategia de escritura merge (upsert = update + insert) que, si un registro reaparece, lo actualiza en lugar de insertarlo de nuevo.
Las tres estrategias de escritura (write disposition) que usaremos:
append: añade siempre. Rápido, pero duplica si reejecutas.replace: borra y reescribe la tabla entera. Útil para full loads pequeños.merge: upsert por clave primaria. Es la base de la carga incremental idempotente.
Backfills
Un backfill es una recarga histórica: quieres traer datos anteriores al punto donde arrancó tu pipeline, o reprocesar un tramo pasado porque la fuente lo corrigió.
Con un cursor bien definido, un backfill se traduce simplemente en fijar el valor inicial del cursor más atrás y dejar que merge reconcilie. Si no tuviéramos clave primaria, un backfill duplicaría los datos.
APIs y paginación
Las fuentes REST rara vez devuelven todo de una vez. Hay que recorrer páginas, y conviene reconocer los tres esquemas habituales:
- Offset/limit: pides
?offset=0&limit=1000, luego?offset=1000, etc. Es la que usa, por ejemplo, la API CKAN de datos abiertos. - Cursor/keyset: la respuesta trae un token para la siguiente página. Más eficiente en tablas grandes que el offset. Por ejemplo, la API de GitHub devuelve
nexten el encabezadoLink. - Página numerada:
?page=1,?page=2. Variante del offset con números de página.
A esto se añaden los límites de peticiones (rate limits) y los reintentos ante errores transitorios.
Todos estos mecanismos son tediosos y propenso a errores, y son lo que dlt resuelve por nosotros.
dlt
dlt es una librería de Python de código abierto (licencia Apache 2.0) para construir pipelines de ingesta en código. No es un servicio ni un servidor: se instala con pip y se ejecuta allí donde corra Python —un script, un notebook, una función serverless o un DAG de Airflow—.
Se encarga de la inferencia y evolución de esquema, la normalización de JSON anidado, la carga incremental, la gestión de estado y los reintentos.
Aunque en nuestro contenedor iabd-lab ya lo tenemos instalado (recuerda que te puedes conectar mediante docker exec -it iabd-lab bash), si quieres instalarlo en tu entorno local puedes hacerlo con:
pip install "dlt[duckdb,parquet,s3]"
El extra duckdb instala el destino DuckDB; parquet habilita la escritura en Parquet; s3 añade s3fs/botocore para escribir en MinIO/S3.
Ya sea conectado a un notebook o en un terminal, puedes comprobar que la instalación fue correcta con:
dlt --version
# dlt 1.29.0
Antes de meternos de lleno con el código, hay tres conceptos que conviene tener claros:
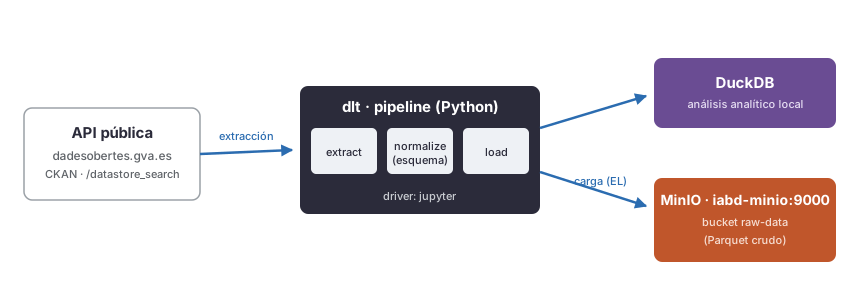
resource: función generadora que produce registros (losyield) de una tabla. Se decora con@dlt.resourcey ahí se declara la clave primaria, la estrategia de escritura y el cursor.source: una agrupación lógica de resources que pertenecen a la misma fuente (por ejemplo, varias tablas de la misma API). Se decora con@dlt.source.pipeline: el objeto que conecta la fuente con un destino y ejecuta el ciclo extract → normalize → load.
La arquitectura general de un pipeline dlt es:
Inferencia de esquema
Una de las características más potentes de dlt es la inferencia de esquema. Cuando declaramos un resource, dlt mira los datos, deduce tipos y crea las tablas por nosotros, sin que tengamos que escribir ningún CREATE TABLE.
Además añade dos columnas de trazabilidad a cada tabla, _dlt_load_id (identifica la ejecución que insertó la fila) y _dlt_id (identificador único de fila), que resultan muy útiles para auditar cargas.
Hola dlt
Vamos a construir un pipeline por capas para entender cómo funciona dlt. La fuente de datos que vamos a emplear son mediciones de calidad del aire de estaciones de la Comunitat Valenciana, con la misma forma que devuelve una API REST. Trabajaremos con un cuaderno Jupyter desde el contenedor iabd-lab, que ya tiene dlt instalado y configurado para escribir en DuckDB y MinIO.
El primer paso, es escribir un resource mock que simule la respuesta de una API pública y lo cargue en DuckDB. No declaramos tipos ni tablas: dlt infiere el esquema y crea la tabla por nosotros.
import dlt

# Un resource simula la respuesta de una API pública (lista de registros JSON)
@dlt.resource(table_name="mediciones")
def api_calidad_aire():
    yield [
        {"id": 1, "estacion": "Valencia - Pista de Silla", "fecha": "2026-01-01", "no2": 34.2},
        {"id": 2, "estacion": "Alacant - Rabassa", "fecha": "2026-01-01", "no2": 21.5},
        {"id": 3, "estacion": "Castelló - Grau", "fecha": "2026-01-02", "no2": 18.0},
    ]

pipeline = dlt.pipeline(
    pipeline_name="calidad_aire",
    destination="duckdb",
    dataset_name="staging",
)

info = pipeline.run(api_calidad_aire)
print(info)
# Pipeline calidad_aire load step completed in 0.31 seconds
# 1 load package(s) were loaded to destination duckdb and into dataset staging
# The duckdb destination used duckdb:////workspace/calidad_aire.duckdb location to store data
# Load package 1787473925.6162927 is LOADED and contains no failed jobs
Si nos conectamos a DuckDB y consultamos la tabla staging.mediciones, vemos que los datos ya están ahí:
import duckdb
con = duckdb.connect("calidad_aire.duckdb")

con.sql("describe staging.mediciones").show()
# ┌──────────────┬─────────────┬─────────┬─────────┬─────────┬─────────┐
# │ column_name  │ column_type │  null   │   key   │ default │  extra  │
# │   varchar    │   varchar   │ varchar │ varchar │ varchar │ varchar │
# ├──────────────┼─────────────┼─────────┼─────────┼─────────┼─────────┤
# │ id           │ BIGINT      │ YES     │ NULL    │ NULL    │ NULL    │
# │ estacion     │ VARCHAR     │ YES     │ NULL    │ NULL    │ NULL    │
# │ fecha        │ VARCHAR     │ YES     │ NULL    │ NULL    │ NULL    │
# │ no2          │ DOUBLE      │ YES     │ NULL    │ NULL    │ NULL    │
# │ _dlt_load_id │ VARCHAR     │ NO      │ NULL    │ NULL    │ NULL    │
# │ _dlt_id      │ VARCHAR     │ NO      │ NULL    │ NULL    │ NULL    │
# └──────────────┴─────────────┴─────────┴─────────┴─────────┴─────────┘

con.sql("select * from staging.mediciones").show()
# ┌───────┬───────────────────────────┬────────────┬────────┬────────────────────┬────────────────┐
# │  id   │         estacion          │   fecha    │  no2   │    _dlt_load_id    │    _dlt_id     │
# │ int64 │          varchar          │  varchar   │ double │      varchar       │    varchar     │
# ├───────┼───────────────────────────┼────────────┼────────┼────────────────────┼────────────────┤
# │     1 │ Valencia - Pista de Silla │ 2026-01-01 │   34.2 │ 1787473925.6162927 │ nDUBvef1Jy/0tw │
# │     2 │ Alacant - Rabassa         │ 2026-01-01 │   21.5 │ 1787473925.6162927 │ XLqb69BQcB43XQ │
# │     3 │ Castelló - Grau           │ 2026-01-02 │   18.0 │ 1787473925.6162927 │ hY0qAsK0TBuaSA │
# └───────┴───────────────────────────┴────────────┴────────┴────────────────────┴────────────────┘
Como puedes observar, no hemos declarado tipos ni tablas y ha realizado la inferencia del esquema, además de las dos columnas que habíamos comentado ( _dlt_load_id, que identifica la ejecución que insertó la fila y _dlt_id, el identificador único de fila.
Carga incremental idempotente
Una vez realizado el caso básico, vamos a simular la carga incremental. Para ello, vamos a ejecutar tres veces el mismo pipeline, pero con distintos lotes de datos. La primera ejecución será la carga inicial, la segunda será una reejecución idéntica y la tercera traerá datos nuevos y un campo nuevo.
Para ello, vamos a simular los datos con un diccionario que contiene tres lotes de datos. Cada lote representa una ejecución del pipeline y contiene los registros que se van a cargar en esa ejecución.
DATOS = {
    "1": [  # carga inicial: histórico hasta 2026-01-03
        {"id": 1, "estacion": "Valencia", "fecha": "2026-01-01", "no2": 34.2},
        {"id": 2, "estacion": "Alacant", "fecha": "2026-01-02", "no2": 21.5},
        {"id": 3, "estacion": "Castelló", "fecha": "2026-01-03", "no2": 18.0},
    ],
    "2": [  # reejecución idéntica: los mismos datos
        {"id": 1, "estacion": "Valencia", "fecha": "2026-01-01", "no2": 34.2},
        {"id": 2, "estacion": "Alacant", "fecha": "2026-01-02", "no2": 21.5},
        {"id": 3, "estacion": "Castelló", "fecha": "2026-01-03", "no2": 18.0},
    ],
    "3": [  # datos nuevos + un campo nuevo "o3"
        {"id": 3, "estacion": "Castelló", "fecha": "2026-01-03", "no2": 18.0},
        {"id": 4, "estacion": "Elx", "fecha": "2026-01-04", "no2": 40.1, "o3": 55},
        {"id": 5, "estacion": "Gandia", "fecha": "2026-01-05", "no2": 29.7, "o3": 61},
    ],
}
A continuación, vamos a declarar un resource que simule la respuesta de la API y que use un cursor incremental sobre el campo fecha. Además, vamos a declarar una clave primaria sobre el campo id y una estrategia de escritura merge para que, si un registro reaparece, lo actualice en lugar de insertarlo de nuevo.
Después, basta con declarar un cursor con dlt.sources.incremental sobre el campo fecha y su valor inicial:
import dlt

# DATOS = { "1": [...], "2": [...], "3": [...] }  # como se ha definido antes

@dlt.resource(table_name="mediciones", primary_key="id", write_disposition="merge")
def mediciones(fecha=dlt.sources.incremental("fecha", initial_value="2026-01-01")):
    for row in DATOS[LOTE]:
        yield row

pipeline = dlt.pipeline(pipeline_name="calidad_aire_inc", destination="duckdb", dataset_name="staging")
Y ejectuamos el pipeline con pipeline.run(mediciones) tres veces, cambiando el lote de datos cada vez. La primera ejecución será la carga inicial, la segunda será una reejecución idéntica y la tercera traerá datos nuevos y un campo nuevo.
LOTE = "1"
info = pipeline.run(mediciones) # carga inicial

LOTE = "2"
info = pipeline.run(mediciones) # reejecución idéntica

LOTE = "3"
info = pipeline.run(mediciones) # datos nuevos + campo nuevo
Autoevaluación
Antes de seguir leyendo, reflexiona. ¿Qué esperas que pase en cada ejecución? ¿Cuántas filas habrá en la tabla final? ¿Qué pasará con el campo o3 en las filas antiguas?
Si volvemos a DuckDB y consultamos la tabla staging.mediciones, vemos que los datos se han cargado correctamente y que el campo o3 se ha añadido a las filas nuevas, mientras que las filas antiguas tienen NULL en ese campo.
La tabla final tiene cinco filas, sin duplicados pese a que el registro id=3 se envió dos veces. La columna o3 aparece automáticamente y queda a NULL en las filas antiguas:
import duckdb
con = duckdb.connect("calidad_aire_inc.duckdb")
con.sql("select * from staging.mediciones").show()
-- ┌───────┬──────────┬────────────┬────────┬────────────────────┬────────────────┬───────┐
-- │  id   │ estacion │   fecha    │  no2   │    _dlt_load_id    │    _dlt_id     │  o3   │
-- │ int64 │ varchar  │  varchar   │ double │      varchar       │    varchar     │ int64 │
-- ├───────┼──────────┼────────────┼────────┼────────────────────┼────────────────┼───────┤
-- │     1 │ Valencia │ 2026-01-01 │   34.2 │ 1787475616.741127  │ /ZkBUM/95aAcQg │  NULL │
-- │     2 │ Alacant  │ 2026-01-02 │   21.5 │ 1787475616.741127  │ GJnzM6FI5QZQig │  NULL │
-- │     3 │ Castelló │ 2026-01-03 │   18.0 │ 1787475616.741127  │ cALFhQtaWhKEbQ │  NULL │
-- │     4 │ Elx      │ 2026-01-04 │   40.1 │ 1787475630.0035374 │ 8Hb9mAL1Jz4pag │    55 │
-- │     5 │ Gandia   │ 2026-01-05 │   29.7 │ 1787475630.0035374 │ oa91XD6sXmil9Q │    61 │
-- └───────┴──────────┴────────────┴────────┴────────────────────┴────────────────┴───────┘
Auditoría de cargas
Si queremos auditar qué pasó en cada ejecución, dlt mantiene tres tablas de control junto a nuestras tablas de datos:
_dlt_loads: cada fila representa una ejecución del pipeline, con suload_id, fecha y hora, número de filas cargadas y estado._dlt_version: cada fila representa una versión de esquema, con suversion_id, fecha y hora, número de tablas y columnas, y estado._dlt_pipeline_state: cada fila representa el estado del cursor de cada resource, con suresource_name,cursor_valuey fecha y hora de la última actualización.
Por ejemplo, si consultamos la tabla _dlt_loads vemos que hay dos cargas efectivas, no tres: la segunda ejecución no escribió nada, lo que nos demuestra la idempotencia:
con.sql("select * from staging._dlt_loads").show()
-- ┌────────────────────┬─────────────┬────────┬───────────────────────────────┬──────────────────────────────────────────────┐
-- │      load_id       │ schema_name │ status │          inserted_at          │             schema_version_hash              │
-- │      varchar       │   varchar   │ int64  │   timestamp with time zone    │                   varchar                    │
-- ├────────────────────┼─────────────┼────────┼───────────────────────────────┼──────────────────────────────────────────────┤
-- │ 1787475616.741127  │ aire_inc    │      0 │ 2026-08-23 09:00:17.163356+00 │ A5qs48lVLlOr92pH8ijnOPP4+CR/jGyzueEhDFrWwXc= │
-- │ 1787475630.0035374 │ aire_inc    │      0 │ 2026-08-23 09:00:30.45951+00  │ bRbx/SJKSjUgMou/b6vNhcUg4cvaYInqUs97FRXRP3w= │
-- └────────────────────┴─────────────┴────────┴───────────────────────────────┴──────────────────────────────────────────────┘
Caso 1 - Usando un API
Vamos a pasar a una fuente real sustituyendo el bucle que produce los registros. Vamos a conectarnos a la Red Valenciana de Vigilancia y Control de la Contaminación Atmosférica (RVVCCA), que publica sus mediciones en el portal de Datos Abiertos de la Generalitat con actualización diaria.
El conjunto de datos que nos interesa es med-cont-atmos-md-v2-2026, con las medias diarias de contaminantes y variables meteorológicas de todas las estaciones de la Comunitat.
CKAN
Cuando decimos que un API es CKAN (Comprehensive Knowledge Archive Network), nos referimos a que sigue el estándar de la plataforma CKAN, que es la que usan muchos portales de datos abiertos. Para más información, consulta la documentación oficial.
Al tratarse de un API de tipo CKAN, el endpoint datastore_search acepta resource_id (obligatorio), filters (condiciones que se han de cumplir), sort, limit y offset, y devuelve los registros en result.records:
Antes de ejecutarlo, conviene abrir la petición en el navegador para ver la forma exacta de la respuesta. Un ejemplo de petición básica sería:
https://dadesobertes.gva.es/api/3/action/datastore_search?resource_id=0f06c6db-ec58-4ac4-9913-5f91022ce829&limit=1
Mediante el parámetro &limit=1 le indicamos al endpoint que queremos un único registro. En result.records aparecen los registros, y en result.fields aparecen los campos con sus tipos tal como los ha inferido el datastore:
{"help": "https://dadesobertes.gva.es/api/3/action/help_show?name=datastore_search", "success": true, "result":
    {"include_total": true, "limit": 1, "records_format": "objects", "resource_id": "0f06c6db-ec58-4ac4-9913-5f91022ce829", "total_estimation_threshold": null,
    "records": [{"_id":1,
        "cd_estacion":"03009006",
        "ds_estacion":"Alcoi - Verge dels Lliris",
        "cd_provincia":"03",
        "provincia":"Alicante/Alacant",
        "fecha":"27/08/2026",
        "identificador":"CO",
        "ds_identificador":"Monóxido de Carbono",
        "ds_medicion":"Absorción Infrarroja",
        "valor":"0",
        "unidad":"mg/m3"}],
    "fields": [{"id": "_id", "type": "int"}, {"id": "cd_estacion", "type": "text", "info": {"label": "", "notes": "Codi de l'estaci\u00f3 / C\u00f3digo de la estaci\u00f3n", "type_override": "text"}}, {"id": "ds_estacion", "type": "text", "info": {"label": "", "notes": "Nom de l'estaci\u00f3 / Nombre de la estaci\u00f3n", "type_override": "text"}}, {"id": "cd_provincia", "type": "text", "info": {"label": "", "notes": "Codi de la provincia on est\u00e1 situada l'estaci\u00f3 / C\u00f3digo de la provincia donde est\u00e1 situada la estaci\u00f3n", "type_override": "text"}}, {"id": "provincia", "type": "text", "info": {"label": "", "notes": "Prov\u00edncia on est\u00e0 situada l'estaci\u00f3 / Provincia donde est\u00e1 situada la estaci\u00f3n", "type_override": "text"}}, {"id": "fecha", "type": "text", "info": {"label": "", "notes": "Data en la qual s'obt\u00e9 la informaci\u00f3 / Fecha en la que se obtiene la informaci\u00f3n", "type_override": "text"}}, {"id": "identificador", "type": "text", "info": {"label": "", "notes": "Par\u00e0metre (contaminant o meteorol\u00f2gic) que es mesura / Par\u00e1metro (contaminante o meteorol\u00f3gico) que se mide", "type_override": "text"}}, {"id": "ds_identificador", "type": "text", "info": {"label": "", "notes": "Descripci\u00f3 del par\u00e0metre que es mesura / Descripci\u00f3n del par\u00e1metro que se mide", "type_override": "text"}}, {"id": "ds_medicion", "type": "text", "info": {"label": "", "notes": "Nom de la t\u00e8cnica de mesurament / Nombre de la t\u00e9cnica de medici\u00f3n", "type_override": "text"}}, {"id": "valor", "type": "text", "info": {"label": "", "notes": "Valor mesurat. Mitjana di\u00e0ria / Valor medido. Media diaria", "type_override": "text"}}, {"id": "unidad", "type": "text", "info": {"label": "", "notes": "Unitat de mesura / Unidad de medida", "type_override": "text"}}],
    "_links": {"start": "/api/3/action/datastore_search?resource_id=0f06c6db-ec58-4ac4-9913-5f91022ce829&limit=1", "next": "/api/3/action/datastore_search?resource_id=0f06c6db-ec58-4ac4-9913-5f91022ce829&limit=1&offset=1"},
    "total": 2000,
    "total_was_estimated": false}}
Los campos obtenidos son:
| Campo | Descripción |
|---|---|
cd_estacion |
Código de la estación |
ds_estacion |
Nombre de la estación |
cd_provincia / provincia |
Provincia donde está situada |
fecha |
Fecha en la que se obtiene la información |
identificador |
Parámetro medido (contaminante o meteorológico) |
ds_identificador |
Descripción del parámetro |
ds_medicion |
Nombre de la técnica de medición |
valor |
Valor medido (media diaria) |
unidad |
Unidad de medida |
En nuestro caso, vamos a filtrar por la estación de Elx - Parc de Bombers (cd_estacion=03065007) y traeremos todas las mediciones disponibles desde el 1 de enero de 2026 en adelante, aunque el recurso únicamente contiene últimos 2000 registros. La API devuelve los registros ordenados por fecha ascendente, así que podemos usar la fecha como cursor incremental.
Así pues, el resource que vamos a declarar en dlt hace una petición a la API, recorre las páginas y devuelve los registros. La clave primaria será la combinación de estación, fecha y parámetro, y el cursor incremental será la fecha.
import json
import dlt
from dlt.sources.helpers import requests   # cliente con reintentos incluido

BASE = "https://dadesobertes.gva.es/api/3/action/datastore_search"
RECURSO = "0f06c6db-ec58-4ac4-9913-5f91022ce829"   # medidas por días, últimos registros
ESTACION = "03065007"                              # Elx - Parc de Bombers

@dlt.resource(
    table_name="mediciones",
    primary_key=["cd_estacion", "fecha", "identificador"],
    write_disposition="merge",
)
def mediciones(fecha=dlt.sources.incremental("fecha", initial_value="2026-01-01")):
    offset = 0
    while True:
        r = requests.get(BASE, params={
            "resource_id": RECURSO,
            "filters": json.dumps({"cd_estacion": ESTACION}),
            "sort": "fecha asc",
            "limit": 100,
            "offset": offset,
        })
        pagina = r.json()["result"]["records"]
        if not pagina:
            break
        yield pagina
        offset += len(pagina)

pipeline = dlt.pipeline(
    pipeline_name="rvvcca",
    destination="duckdb",
    dataset_name="raw",
)

print(pipeline.run(mediciones))
¿Por qué calcular el offset a mano si la respuesta trae _links.next?
CKAN incluye en cada respuesta un enlace a la página siguiente. Podríamos seguirlo, pero calcular el desplazamiento a partir de los registros que hemos recibido de verdad (offset += len(pagina)) es más robusto: si el servidor devolviera menos filas de las solicitadas, o si el enlace viniera mal construido, nuestro bucle se autocorrige en lugar de saltarse datos silenciosamente.
Datos en formato largo
Fíjate en la forma de los registros: no hay una columna por contaminante, sino una fila por cada parámetro medido.
Vamos a conectarnos al CLI de DuckDB:
docker exec -it iabd-lab duckdb -readonly rvvcca.duckdb
Y ejecutamos la consulta para ver las mediciones de la estación Elx - Parc de Bombers desde el 1 de enero de 2026:
SELECT cd_estacion, fecha, identificador, valor, unidad FROM raw.mediciones
         WHERE cd_estacion = '03065007' AND fecha >= '2026-01-01'
         ORDER BY fecha, identificador LIMIT 10;
-- ┌─────────────┬────────────┬───────────────┬─────────┬─────────┐
-- │ cd_estacion │   fecha    │ identificador │  valor  │ unidad  │
-- │   varchar   │  varchar   │    varchar    │ varchar │ varchar │
-- ├─────────────┼────────────┼───────────────┼─────────┼─────────┤
-- │ 03065007    │ 24/08/2026 │ C6H6          │ 0.1     │ ug/m3   │
-- │ 03065007    │ 24/08/2026 │ C7H8          │ 0.2     │ ug/m3   │
-- │ 03065007    │ 24/08/2026 │ C8H10         │ 0.2     │ ug/m3   │
-- │ 03065007    │ 24/08/2026 │ CO            │ 0       │ mg/m3   │
-- │ 03065007    │ 24/08/2026 │ NO            │ 1       │ ug/m3   │
-- │ 03065007    │ 24/08/2026 │ NO2           │ 2       │ ug/m3   │
-- │ 03065007    │ 24/08/2026 │ NOx           │ 4       │ ug/m3   │
-- │ 03065007    │ 24/08/2026 │ O3            │ 62      │ ug/m3   │
-- │ 03065007    │ 24/08/2026 │ SO2           │ 2       │ ug/m3   │
-- │ 03065007    │ 25/08/2026 │ C6H6          │ 0.1     │ ug/m3   │
-- └─────────────┴────────────┴───────────────┴─────────┴─────────┘
Como puedes ver, C6H6, O3 y el resto de contaminantes no son columnas, sino valores del campo identificador. Este diseño se llama formato largo y es muy habitual en las fuentes de datos abiertos, porque permite añadir parámetros nuevos sin cambiar la estructura de la tabla. Para analizar necesitaremos girarlo a formato ancho, con una columna por contaminante, aplicando la operación de pivotar que vimos en la sesión de SQL analítico.
Y aquí es donde se ve el sentido del EL: la ingesta carga el dato tal como viene, en formato largo, sin decidir nada. Girar la tabla es una transformación, y la haremos en la capa de transformación con dbt, donde queda versionada y documentada.
Comprobar la carga incremental de verdad
Como el conjunto se actualiza a diario, tenemos un escenario real sin inventar nada. Ejecuta el pipeline y consulta el cursor en pipeline.state; vuelve a ejecutarlo inmediatamente y comprobarás que no se carga ninguna fila ni se genera ningún paquete de carga (idempotencia). Al día siguiente, la misma ejecución traerá sólo las mediciones nuevas.
Para repetir la prueba desde cero, no cambies initial_value: ese valor sólo se aplica cuando todavía no hay estado guardado, y a partir de la primera ejecución lo ignora. Usa pipeline.run(mediciones, refresh="drop_resources"), que descarta el estado del recurso y vuelve a empezar.
Configuración y credenciales
Hasta ahora hemos escrito el pipeline en un único fichero, pero un proyecto real necesita separar el código de la configuración. dlt trae un comando que prepara el esqueleto. Para ello, si queremos crear un nuevo proyecto que llamaremos dlt_gva, abrimos un terminal dentro del cuaderno de Jupyter y ejecutamos:
mkdir dlt_gva
cd dlt_gva
dlt init dlt_gva duckdb
El comando crea la carpeta .dlt con dos ficheros y un requirements.txt con las dependencias del origen y del destino elegidos:
.
├── requirements.txt
├── dlt_gva_pipeline.py
└── .dlt
    ├── config.toml
    └── secrets.toml
La distinción entre los dos ficheros de la carpeta .dlt es importante:
| Fichero | Qué contiene | ¿Va al repositorio? |
|---|---|---|
config.toml |
Parámetros no sensibles: rutas, nombres de tabla, URL de buckets | Sí |
secrets.toml |
Credenciales: claves de API, usuarios y contraseñas de bases de datos | No |
secrets.toml nunca se sube al repositorio
El dlt init añade un .gitignore que ya excluye secrets.toml. Si creas el proyecto a mano, asegúrate de excluirlo tú: subir credenciales a un repositorio es uno de los errores más peligrosos que podemos cometer.
Caso 2 - Carga en MinIO
Antes de nada, para trabajar con Minio/S3, necesitamos instalar el paquete dlt[filesystem] para trabajar con sistemas de ficheros y almacenamiento en la nube:
pip install "dlt[filesystem]"
A continuación, vamos a cambiar el destino de DuckDB a MinIO. Para ello, basta con cambiar la sección destination al destino filesystem. ¿Y dónde ponemos las credenciales?
Para ello, en el fichero secrets.toml del directorio .dlt del proyecto, almacenaremos las credenciales de acceso a MinIO. Como hemos comentando antes, este fichero no se sube al repositorio, así que no hay riesgo de exponer las credenciales.
[destination.filesystem]
bucket_url = "s3://raw-data"

[destination.filesystem.credentials]
aws_access_key_id = "minioadmin"
aws_secret_access_key = "minioadmin123"
endpoint_url = "http://iabd-minio:9000"
s3_url_style = "path"
Y el pipeline se ejecuta igual que antes, pero ahora escribe en MinIO en lugar de DuckDB:
import dlt

pipeline = dlt.pipeline(
    pipeline_name="rvvcca",
    destination="filesystem",
    dataset_name="rvvcca",
)
pipeline.run(mediciones, loader_file_format="parquet")
Al ejecutar el pipeline, dlt crea un dataset llamado rvvcca en el bucket raw-data de MinIO, y dentro de él crea una carpeta por cada resource que hemos definido. En nuestro caso, la carpeta se llama mediciones, y dentro de ella se crean los ficheros Parquet con los datos cargados, con la siguiente estructura:
raw_data/rvvcca/mediciones/1787997534.4526932.0e3a62ef3a.parquet
raw_data/rvvcca/_dlt_loads/...
raw_data/rvvcca/_dlt_version/...
raw_data/rvvcca/_dlt_pipeline_state/...
Y tal como hemos realizado en sesión anteriores, si queremos consultar los datos, desde DuckDB podemos leer directamente los ficheros Parquet que dlt ha escrito en MinIO, sin necesidad de moverlos a otro sitio. Para ello, basta con usar la función httpfs de DuckDB, que permite leer ficheros desde un endpoint S3 compatible con MinIO.
Recuerda que primero hay que cargar la función httpfs de DuckDB, que permite leer ficheros desde un endpoint S3 compatible con MinIO.
INSTALL httpfs;
LOAD httpfs;
Y configurar las mismas credenciales que pusimos en secrets.toml mediante la sentencia CREATE OR REPLACE SECRET:
CREATE OR REPLACE SECRET minio (
    TYPE s3,
    KEY_ID 'minioadmin',
    SECRET 'minioadmin123',
    ENDPOINT 'minio:9000',
    URL_STYLE 'path',
    USE_SSL false
);
Y luego realizamos la consulta teniendo en cuenta que los datos están almacenados en formato largo, así que si queremos calcular la media de NO2 por estación, debemos filtrar por identificador = 'NO2' y agrupar por cd_estacion:
SELECT cd_estacion, avg(valor::FLOAT) AS media_no2
FROM 's3://raw-data/rvvcca/mediciones/*.parquet'
WHERE identificador = 'NO2' AND fecha >= '2026-01-01'
GROUP BY cd_estacion;
-- ┌─────────────┬───────────┐
-- │ cd_estacion │ media_no2 │
-- │   varchar   │  double   │
-- ├─────────────┼───────────┤
-- │ 03065007    │      2.25 │
-- └─────────────┴───────────┘
Caso 3 - Extrayendo de una base de datos relacional
Las APIs no son la única fuente de datos; de hecho, en una empresa la fuente más habitual es la base de datos operacional que sostiene el negocio. En nuestro stack tenemos retail_db en MySQL, que es justamente eso: el sistema donde se registran clientes, pedidos y productos.
dlt trae un origen específico para bases de datos relacionales. Para ello, necesitamos instalar un extra adicional:
pip install "dlt[sql_database]"
Mediante la función sql_table() extraemos una tabla concreta, y lo bueno es que el patrón incremental es exactamente el mismo que acabamos de ver con la API: cursor, clave primaria y merge:
import dlt
from dlt.sources.sql_database import sql_table

pedidos = sql_table(
    credentials="mysql+pymysql://root:rootpass@mysql:3306/retail_db",
    table="orders",
    incremental=dlt.sources.incremental("order_date", initial_value=datetime.datetime(2013, 1, 1)),
    write_disposition="merge",
    primary_key="order_id",
)

pipeline = dlt.pipeline(
    pipeline_name="retail_el",
    destination="duckdb",
    dataset_name="raw",
)

info = pipeline.run(pedidos)
print("filas cargadas:", pipeline.last_trace.last_normalize_info.row_counts.get("orders", 0))
# filas cargadas: 38221
Credenciales de conexión
Para ocultar las credenciales, podemos guardarlas en el fichero .dlt/secrets.toml dentro de la sección [sources.sql_database.credentials]:
[sources.sql_database.credentials]
drivername = "mysql+pymysql"
username = "root"
password = "rootpass"
host = "mysql-retail"
port = 3306
database = "retail_db"
El initial_value debe ser del mismo tipo que la columna
Al extraer de una API, las fechas llegan como texto en el JSON y el cursor se inicializa con una cadena. Al extraer de una base de datos, en cambio, el conector devuelve el tipo real de la columna: si order_date es DATETIME, hay que pasar un objeto datetime, no una cadena. En caso contrario dlt no puede comparar los valores y la extracción falla con un error de tipos.
Tras su ejecución, la tabla raw.orders en DuckDB contiene los pedidos de retail_db. Podemos comprobarlo conectándonos a DuckDB:
docker exec -it iabd-de-lab duckdb -readonly retail_el.duckdb
Y consultando la tabla raw.orders:
SELECT count(*) FROM raw.orders;
-- ┌──────────────┐
-- │ count_star() │
-- │    int64     │
-- ├──────────────┤
-- │        38221 │
-- └──────────────┘
Comprobando la carga incremental
Vamos a comprobar que la carga incremental funciona correctamente. Para ello, tras haber ejecutado el pipeline una primera vez para cargar los pedidos existentes, primero vamos a comprobar cuales son los últimos pedidos cargados.
SELECT order_id, order_date FROM raw.orders ORDER BY order_date DESC LIMIT 5;
-- ┌──────────┬─────────────────────┐
-- │ order_id │     order_date      │
-- │  int64   │      timestamp      │
-- ├──────────┼─────────────────────┤
-- │    57603 │ 2014-07-24 00:00:00 │
-- │    57624 │ 2014-07-24 00:00:00 │
-- │    57632 │ 2014-07-24 00:00:00 │
-- │    57633 │ 2014-07-24 00:00:00 │
-- │    57659 │ 2014-07-24 00:00:00 │
-- └──────────┴─────────────────────┘
A continuación, nos vamos a conectar a MySQL:
docker exec -it iabd-de-mysql-retail mysql -u root -prootpass retail_db
E insertamos un pedido nuevo en la base de datos retail_db con la fecha actual (no le indicamos valores en la clave primaria order_id porque es autoincremental):
INSERT INTO orders (order_date, order_customer_id, order_status)
VALUES ('2026-08-30', 101, 'PENDING');
A continuación, volvemos a ejecutar el pipeline (pipeline.run(pedidos)) y comprobamos que sólo se ha cargado el pedido nuevo consultando la tabla raw.orders en DuckDB:
SELECT order_id, order_date FROM raw.orders ORDER BY order_date DESC LIMIT 5;
-- ┌──────────┬─────────────────────┐
-- │ order_id │     order_date      │
-- │  int64   │      timestamp      │
-- ├──────────┼─────────────────────┤
-- │    68884 │ 2026-08-30 00:00:00 │
-- │    57603 │ 2014-07-24 00:00:00 │
-- │    57624 │ 2014-07-24 00:00:00 │
-- │    57632 │ 2014-07-24 00:00:00 │
-- │    57633 │ 2014-07-24 00:00:00 │
-- └──────────┴─────────────────────┘
Cargando varias tablas
Si en vez de una tabla queremos traernos varias, sql_database() hace el trabajo declarando sólo sus nombres:
import dlt
from dlt.sources.sql_database import sql_database

pipeline = dlt.pipeline(
    pipeline_name="retail_el",
    destination="duckdb",
    dataset_name="raw",
)

fuente = sql_database(
    credentials="mysql+pymysql://root:rootpass@mysql:3306/retail_db",
    table_names=["orders", "customers", "categories"],  # si queremos todas las tablas, basta con no pasar este parámetro
)

pipeline.run(fuente, write_disposition="replace")
Este es el origen del pipeline que orquestaremos
Esta extracción de retail_db es la primera etapa del ELT completo: dlt deja el crudo en el lago, dbt lo transforma y Airflow encadena ambos pasos. Lo montaremos de principio a fin en las sesiones de transformación y orquestación.
El cursor debe reflejar también las actualizaciones
Si eliges como cursor un campo que sólo marca la creación del registro (order_date), las modificaciones posteriores de una fila no se detectarán: dlt sólo trae lo que supera el último valor visto. Cuando el origen permita modificar registros, el cursor debe ser un campo de última modificación (updated_at). Capturar cambios de forma fiable sin ese campo requiere otra técnica, CDC, que veremos en el bloque de flujos de datos.
Alternativas a dlt
Actualmente, en el mercado, existen tres herramientas de ingesta de datos que compiten en el mismo espacio: dlt, Airbyte y Fivetran, los cuales se dedican a mover datos de una fuente a un destino desde filosofías distintas.
- dlt sigue un planteamiento de programar en código primero (Code First). Vive en nuestro repositorio, se versiona con git, se testea y se despliega donde ya corre Python. No tiene interfaz gráfica y requiere que, nosotros como desarrolladores, nos ocupemos de programar la ejecución (Airflow, cron, serverless). Es la opción natural para un equipo con perfil de programación que quiere control total y coste cero de licencia.
- Airbyte tiene la filososfía de conectores primero. Aporta un catálogo de más de 600 conectores y una interfaz gráfica. Existe en edición open source autoalojada (gratuita, pero con un coste de operación real sobre Kubernetes/Docker) y en Airbyte Cloud gestionado. Encaja cuando necesitas muchos orígenes distintos y prefieres configurar antes que programar.
- Fivetran es un servicio gestionado. SaaS cerrado, sin nada que operar, con conectores mantenidos por el proveedor y SLA. A cambio, es de pago por volumen (modelo MAR, monthly active rows) y su precio es su mayor inconveniente. Es para organizaciones que prefieren pagar por no tener que mantener nada.
En nuestro caso, para este curso y para proyectos pequeños o medianos con perfil técnico, la mejor opción es dlt: cero infraestructura, todo en Python (que se supone que ya sabemos), y el mismo pipeline sirve para DuckDB en local y para MinIO/S3 en el lago.
¿Y Nifi Y Pentaho?
En cursos anteriores trabajamos la ingesta de datos con herramientas de flujo visual como Pentaho (Kettle), Sqoop y Flume. En este curso hemos decidido no incluirlas en el temario:
- Pentaho es una herramientas de flujo visual, donde la lógica se dibuja en un lienzo. Es un tipo de solución difícil de versionar, testear y revisar en un pull request, y acopla la ingesta a un servidor. Este tipo de herramientas ETL nacieron antes del patrón ELT + lakehouse.
- Sqoop movía datos entre bases relacionales y HDFS; Flume y las herramientas de la sesión de streaming (para eventos). Sqoop, además, es un proyecto retirado en Apache.
- Nifi lo dejaremos para el bloque de flujos, donde tiene sentido: ingesta de eventos en tiempo real, enrutado y filtrado, con backpressure y SLA. Para la ingesta por lotes de APIs y bases de datos,
dltes más simple y más moderno.
En una frase: la ingesta moderna es código y configuración versionables sobre almacenamiento barato, no un servidor de flujos que hay que administrar.
FAQ
A continuación se recogen preguntas habituales sobre los conceptos de esta sesión que suelen realizarse en entrevistas de trabajo para puestos de ingeniería o ciencia de datos.
Despliega cada pregunta para ver una respuesta orientativa; no hay una única respuesta correcta, pero sí aspectos clave que conviene mencionar.
¿Qué diferencia hay entre EL y ELT?
EL es extraer y cargar el dato crudo. ELT añade la T de transformar después, ya dentro del destino. En este curso separamos las dos: dlt hace la EL y la transformación se aborda con dbt en su propia sesión. Por eso hablamos de "EL con dlt".
En dlt, ¿por qué el cursor no vuelve a cargar los datos ya vistos al reejecutar?
Porque dlt persiste el último valor del cursor en la tabla _dlt_pipeline_state. En la siguiente ejecución descarta los registros cuyo valor de cursor no supera al guardado. Si además defines clave primaria con merge, cualquier registro que reaparezca se actualiza en lugar de duplicarse.
¿Qué son las columnas _dlt_load_id y _dlt_id?
Columnas de trazabilidad que dlt añade a cada tabla: _dlt_load_id identifica la ejecución que insertó la fila y _dlt_id es un identificador único de fila. Sirven para auditar qué carga trajo cada dato.
¿Cuándo usar append, replace o merge en dlt?
append para acumular sin clave (por ejemplo, eventos que nunca cambian); replace para recargar por completo tablas pequeñas; merge para carga incremental idempotente con clave primaria, que es el caso más habitual.
En dlt, ¿por qué he cambiado initial_value a una fecha anterior y no se carga nada más?
Porque initial_value sólo se usa en la primera ejecución, cuando el pipeline aún no tiene estado. Después, el cursor guardado tiene prioridad y dlt sigue descartando todo lo anterior a él. Para volver a cargar desde el principio hay que descartar el estado del recurso con refresh="drop_resources".
Referencias
- Documentación oficial en dltHub.
- Tutoriales de dltHub sobre REST API, bases de datos SQL y almacenamiento de objetos.
Actividades
USGS
El servicio de terremotos del United States Geological Survey publica en abierto el catálogo sísmico mundial mediante un API pública, sin registro ni clave, y con datos que se actualizan continuamente: cada pocos minutos entran eventos nuevos y los existentes se revisan.
El endpoint es:
https://earthquake.usgs.gov/fdsnws/event/1/query
Y estos son los parámetros que nos interesan:
| Parámetro | Descripción |
|---|---|
format |
Formato de salida; usaremos geojson |
starttime / endtime |
Acotan el rango temporal, en formato ISO 8601 |
updatedafter |
Limita a los eventos revisados después del instante indicado |
minmagnitude |
Magnitud mínima, útil para reducir el volumen |
orderby |
Orden de los resultados (time, time-asc, magnitude...) |
limit / offset |
Paginación |
Conviene abrir primero una consulta en el navegador para ver la forma de la respuesta antes de escribir nada:
https://earthquake.usgs.gov/fdsnws/event/1/query?format=geojson&starttime=2026-01-01&minmagnitude=6&limit=5
Cada evento del array features trae un identificador propio en id, los atributos en properties (magnitud, lugar, instante) y la localización en geometry.
Dos detalles que conviene mirar antes de empezar
El desplazamiento de la paginación empieza en 1, no en cero, al contrario de lo habitual. Y los instantes (properties.time y properties.updated) no son fechas de texto, sino milisegundos transcurridos desde el 1 de enero de 1970; tenlo en cuenta al fijar el valor inicial del cursor y al interpretar los resultados.
-
(RASBD.3 / CESBD.3a / 1p) Construye un pipeline
dltincremental que cargue el catálogo sísmico del USGS. Debe usarproperties.updatedcomo cursor, el identificador del evento como clave primaria ywrite_disposition="merge". Acota la consulta conminmagnitudepara que el volumen sea razonable y pagina los resultados. La carga cruda debe aterrizar ens3://raw-data/en formato Parquet.Entrega el script y una consulta DuckDB sobre el Parquet resultante que muestre los diez terremotos de mayor magnitud del periodo cargado, con su lugar y su fecha convertida a un formato legible.
Campos anidados por dlt
Fíjate en cómo
dltha tratado la estructura anidada del GeoJSON al inferir el esquema: los campos que venían dentro depropertiesygeometryno han desaparecido. Explica en un par de líneas qué ha hecho y por qué es preferible a guardar el JSON tal cual en una sola columna. -
(RABDA.1 / CEBDA.1b / 1p) Demuestra las dos propiedades que hacen fiable a un pipeline de ingesta, documentando cada una con la salida real:
- Idempotencia. Reejecuta el pipeline inmediatamente, sin cambiar nada, y comprueba que no se carga ninguna fila. Aporta el contenido de
_dlt_loadsmostrando que la segunda ejecución no añadió ninguna carga, y el valor del cursor antes y después. - Evolución de esquema. Modifica el recurso para que incorpore un campo que antes no recogías (por ejemplo, si en la primera versión te quedabas sólo con la magnitud y el lugar, añade ahora el indicador de tsunami o la profundidad). Reejecuta y comprueba que la columna nueva aparece sola en la tabla, sin que hayas escrito ninguna sentencia de modificación, y que las filas cargadas antes quedan con valor nulo en ella.
Repetir la prueba desde cero
Para repetir la prueba desde el principio no cambies el valor inicial del cursor: sólo se aplica cuando todavía no hay estado guardado. Descarta el estado del recurso al ejecutar y volverás al punto de partida.
- Idempotencia. Reejecuta el pipeline inmediatamente, sin cambiar nada, y comprueba que no se carga ninguna fila. Aporta el contenido de
-
(RABDA.1 / CEBDA.1d / opcional) El catálogo del USGS no sólo añade eventos nuevos; también revisa los existentes, porque la magnitud y la localización se recalculan conforme llegan datos de más estaciones. Razona qué habría pasado si hubieras elegido
properties.timecomo cursor en lugar deproperties.updated, y comprueba tu razonamiento buscando en los datos cargados algún evento cuyo instante de revisión sea posterior al de origen. -
(RABDA.1 / CEBDA.1b / 2p) Sobre la base de datos
retail_dbse pide:- Extrae tanto la tabla
ordersya realizada en el caso 3, como la tablacustomers. - Carga ambas tablas en MinIO en formato Parquet, ocultando las credenciales en el fichero de configuración correspondiente.
- Mediante DuckDB, recupera el nombre del cliente que realizó el pedido más reciente y la fecha de ese pedido. Documenta la consulta y la salida real.
- Añade un nuevo pedido a la base de datos
retail_dby reejecuta el pipeline de dlt. Documenta la comprobación con la salida real. - Vuelve a realizar la consulta del punto 3.3 y comprueba que el nuevo pedido aparece correctamente.
- Extrae tanto la tabla